данные для языковых моделей
Качество модели начинается с данных
Мы — команда инженеров данных. Готовим документы и данные, на которых работают языковые модели: корпуса, датасеты, структурирование под RAG и fine-tuning.
почему данные
Качество начинается задолго до первого промпта.
Модель отвечает ровно тем, что лежит в её данных. Если документы собраны без структуры, с дублями и мусором — не поможет ни выбор модели, ни промпты. Мы приводим документы и данные в порядок до того, как они попадут в RAG-систему или в обучение.
как мы работаем
От сырых документов — к готовым данным.
Собираем и чистим корпуса, структурируем документы, размечаем примеры и проверяем качество на каждом шаге. На выходе — данные, готовые к использованию, с документацией по процессу.
- Сбор и чистка корпусов и датасетов
- Чанкинг и метаданные под RAG
- Валидация примеров под fine-tuning
первый шаг
Есть документы или данные, которые нужно подготовить для LLM?
Расскажите, какие документы и данные у вас есть и для какой задачи они готовятся. Предложим план подготовки и оценим объём работ.
форматы работы
Что мы готовим для языковых моделей
Корпуса и датасеты
Документы под RAG
Данные под fine-tuning
Корпуса и датасеты
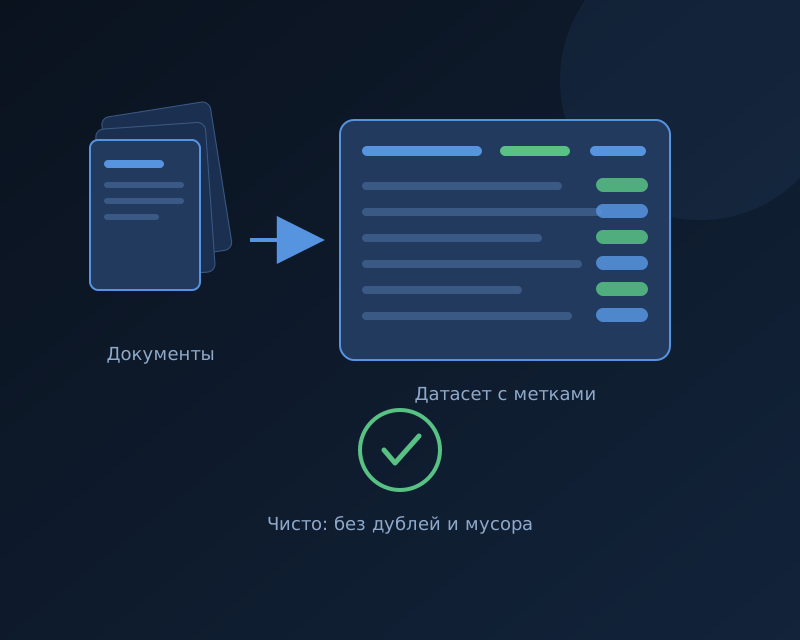
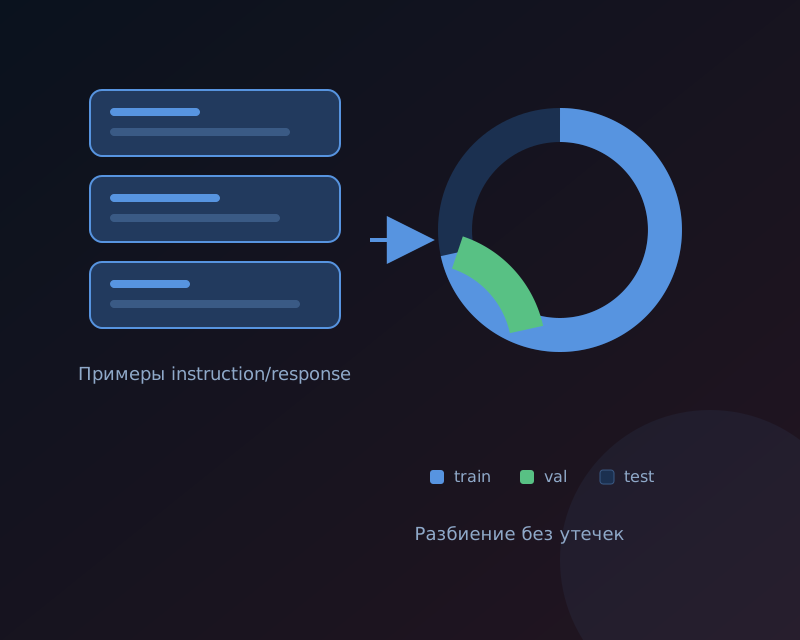
Собираем, чистим и размечаем текстовые корпуса и датасеты под задачи обучения и дообучения моделей.
Документы под RAG
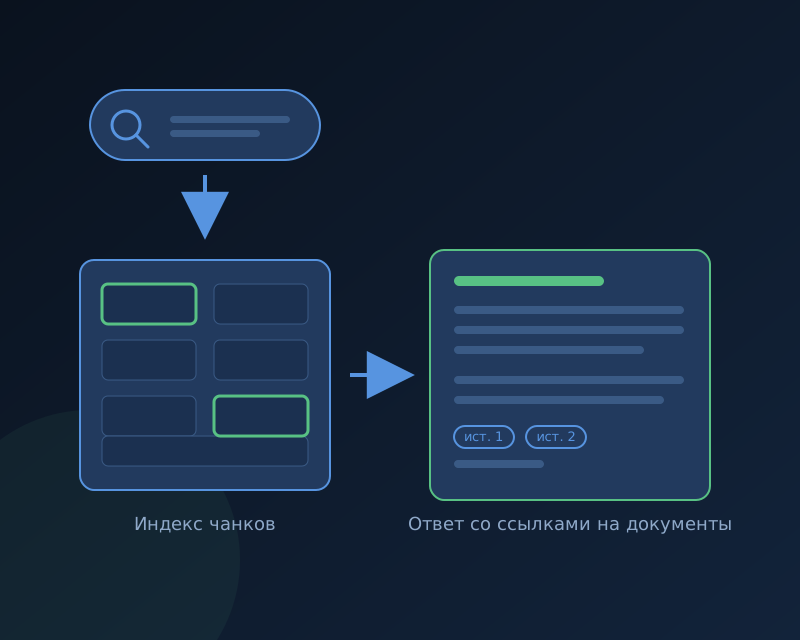
Структурируем документацию для retrieval-augmented generation: чанкинг, метаданные, качество извлечения.
Подготовка под fine-tuning
Готовим инструкционные и доменные датасеты для дообучения: форматы, шаблоны, валидация примеров.
Контроль качества данных
Проверяем полноту, согласованность и чистоту данных: дедупликация, метрики качества, аудит выборок.
Извлечение текста
Достаём текст из PDF, DOCX, HTML и сканов: таблицы, колонтитулы, структура — без потери смысла и без мусора.
Аудит готовности данных
Оцениваем, годятся ли ваши данные для RAG или обучения, и что нужно исправить: карта проблем и план подготовки.
блог
Пишем про данные для LLM — RAG, корпуса, качество
Готовы обсудить задачу?
© Copyright 2026 AI Engineering